




Представьте, что ночью ваш онлайн-сервис по продаже билетов перестал работать. Клиенты пытались оформить заказ, но страница не открывалась. Утром все работало стабильно, но сколько клиентов ушло к конкурентам и кто должен был среагировать на сбой — неизвестно. Именно для избежания подобных ситуаций существует SLA.
В статье расскажем, что такое SLA простыми словами, зачем это нужно бизнесу и техподдержке, как считаются показатели и как выстроить реальный контроль на практике.
Разобраться в вопросе нам помогает Дмитрий Унтила, руководитель «Пульта» и «Графини» в «Лаборатории Числитель», более 10 лет работающий с системами мониторинга ИТ-инфраструктуры.
В статье расскажем, что такое SLA простыми словами, зачем это нужно бизнесу и техподдержке, как считаются показатели и как выстроить реальный контроль на практике.
Разобраться в вопросе нам помогает Дмитрий Унтила, руководитель «Пульта» и «Графини» в «Лаборатории Числитель», более 10 лет работающий с системами мониторинга ИТ-инфраструктуры.
Оглавление
- SLA: зачем нужно и как работает
- Зачем бизнесу мониторинг SLA?
- Показатели SLA: что такое метрики и как их выбрать
- Что такое нарушение SLA и как его предотвратить
- Как контролировать выполнение SLA: инструменты и процессы
- Как «Пульт» и «Графиня» помогают контролировать SLA
- Частые ошибки при внедрении мониторинга SLA и как их избежать
- Главное об SLA
- FAQ
SLA: зачем нужно и как работает
SLA в бизнесе и ИТ
SLA (Service Level Agreement) — это соглашение об уровне сервиса между заказчиком и исполнителем, в котором фиксируются конкретные параметры качества. Например, скорость ответа на критическую заявку в течение 15 минут или 99,9% доступность сервиса.
SLA в ИТ — один из ключевых инструментов управления качеством сервиса. Он переводит техническую реальность («сервер упал на три минуты») на бизнес-язык («доступность за месяц составила 99,3% при плановых 99,9%»). SLA дает единый измеримый показатель, понятный и инженеру, и руководителю. Уровень SLA подразумевает конкретный процент выполнения договоренностей за период.
«SLA — это как мультипликатор, абстракция. Вы начинаете мерить состояние сервиса не на уровне инженера, а на уровне бизнеса», — Дмитрий Унтила, руководитель «Пульта» и «Графини», «Лаборатория Числитель».
SLA в ИТ — один из ключевых инструментов управления качеством сервиса. Он переводит техническую реальность («сервер упал на три минуты») на бизнес-язык («доступность за месяц составила 99,3% при плановых 99,9%»). SLA дает единый измеримый показатель, понятный и инженеру, и руководителю. Уровень SLA подразумевает конкретный процент выполнения договоренностей за период.
«SLA — это как мультипликатор, абстракция. Вы начинаете мерить состояние сервиса не на уровне инженера, а на уровне бизнеса», — Дмитрий Унтила, руководитель «Пульта» и «Графини», «Лаборатория Числитель».
Договор SLA: кто его заключает и что в нём фиксируется
В договоре SLA поставщик берёт на себя обязательства по уровню сервиса, заказчик — по его оплате.
Типичный пример: интернет-провайдер и корпоративный клиент. Для компании, где интернет — жизненно важный ресурс, критически важна уверенность: канал будет работать стабильно с 9 до 18 в рабочие дни, а в случае сбоя провайдер возместит ущерб. Это и есть логика SLA: заказчик платит за гарантии, поставщик услуг берёт ответственность.
В ИТ-отделе или сервисной компании SLA может фиксировать следующие параметры: какие бывают приоритеты заявок, в какие сроки нужно реагировать и решать проблему, что считается нарушением и каковы последствия.
Типичный пример: интернет-провайдер и корпоративный клиент. Для компании, где интернет — жизненно важный ресурс, критически важна уверенность: канал будет работать стабильно с 9 до 18 в рабочие дни, а в случае сбоя провайдер возместит ущерб. Это и есть логика SLA: заказчик платит за гарантии, поставщик услуг берёт ответственность.
В ИТ-отделе или сервисной компании SLA может фиксировать следующие параметры: какие бывают приоритеты заявок, в какие сроки нужно реагировать и решать проблему, что считается нарушением и каковы последствия.
Зачем бизнесу мониторинг SLA?
Во-первых, мониторинг позволяет не только зафиксировать проблему, но и доказать её наличие. Без инструмента контроля разговор между заказчиком и исполнителем легко превращается в бесконечный спор. SLA дает объективную картину: данные, данные и ещё раз данные.
Во-вторых, финансовая защита. Если сервис деградирует или падает, бизнес теряет деньги: напрямую (не продали) или косвенно (клиенты ушли к конкурентам). SLA переводит этот риск в конкретные обязательства: при нарушении последуют штраф или компенсация.
В-третьих, репутация. Любая компания, которая преследует цель предоставлять качественные услуги, рано или поздно приходит к необходимости объективно измерять показатели своей работы.
Во-вторых, финансовая защита. Если сервис деградирует или падает, бизнес теряет деньги: напрямую (не продали) или косвенно (клиенты ушли к конкурентам). SLA переводит этот риск в конкретные обязательства: при нарушении последуют штраф или компенсация.
В-третьих, репутация. Любая компания, которая преследует цель предоставлять качественные услуги, рано или поздно приходит к необходимости объективно измерять показатели своей работы.
Показатели SLA: что такое метрики и как их выбрать
Показатель SLA — это измеримый параметр, который отражает качество предоставляемой услуги. Не все метрики одинаково важны: для разных сервисов приоритеты будут отличаться.
Что такое SLA-метрика? Это конкретная цифра с единицей измерения и пороговым значением. Например: «доступность сервиса — не менее 99,5% в месяц». Время реакции, время решения, доступность: три главных показателя.
Существуют три ключевых показателя, которые встречаются практически в любом SLA:
Что такое SLA-метрика? Это конкретная цифра с единицей измерения и пороговым значением. Например: «доступность сервиса — не менее 99,5% в месяц». Время реакции, время решения, доступность: три главных показателя.
Существуют три ключевых показателя, которые встречаются практически в любом SLA:
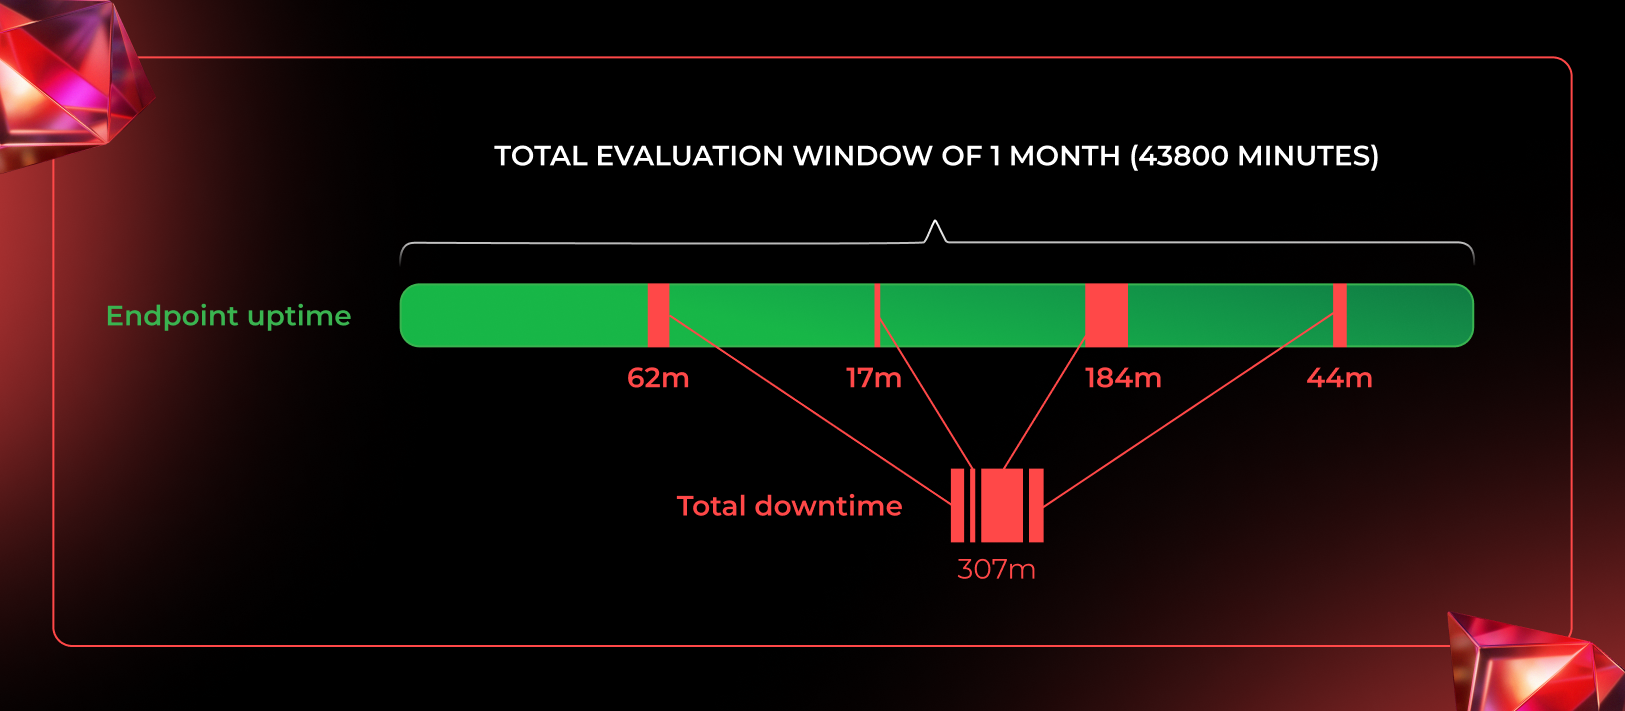
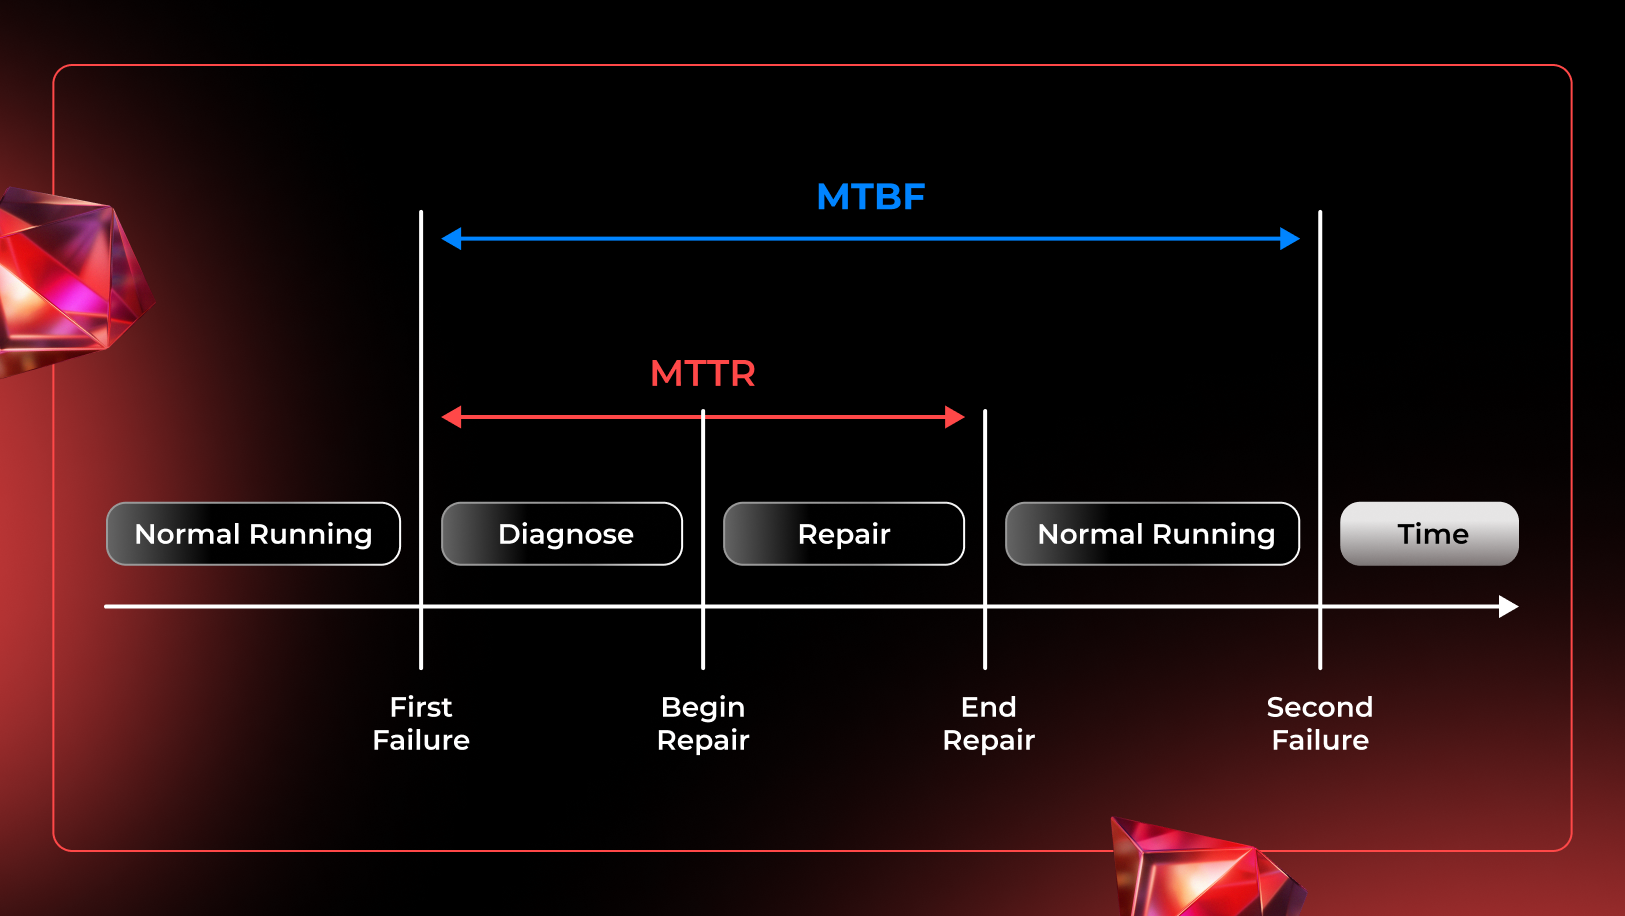
Доступность — центральный показатель для большинства ИТ-сервисов. Разница между 99% и 99,9% кажется незначительной, но на практике это ~88 часов простоя в год vs ~9 часов. Для бизнеса это принципиально.
Стоит сказать, что при расчёте доступности обычно исключаются запланированные технические работы. Если ночью проводится регламентное обслуживание и сервис недоступен — это не нарушение SLA. Для таких случаев вводится понятие «технологическое окно»: согласованный период, который не учитывается при расчёте показателей.
Стоит сказать, что при расчёте доступности обычно исключаются запланированные технические работы. Если ночью проводится регламентное обслуживание и сервис недоступен — это не нарушение SLA. Для таких случаев вводится понятие «технологическое окно»: согласованный период, который не учитывается при расчёте показателей.
Формула и расчёт SLA
Базовая формула расчёта SLA для показателя доступности выглядит так:
SLA (%) = (Время работы сервиса / Общее время периода) x 100
или в другой форме: SLA (%) = ((Общее время − Время простоя) / Общее время) x 100
Если в SLA фиксируется не весь период, а только рабочее время, из знаменателя вычитаются нерабочие часы и согласованные технологические окна.
SLA (%) = (Время работы сервиса / Общее время периода) x 100
или в другой форме: SLA (%) = ((Общее время − Время простоя) / Общее время) x 100
Если в SLA фиксируется не весь период, а только рабочее время, из знаменателя вычитаются нерабочие часы и согласованные технологические окна.
Расчёт SLA на конкретном примере
В качестве примера возьмём интернет-магазин и посмотрим, как считается SLA за месяц (30 дней = 43 200 минут):
Плановая доступность по SLA: 99,5%. Допустимое время простоя: 43 200 x (1 − 0,995) = 216 минут (~3,6 часа). Фактический простой за месяц: 180 минут (два инцидента — 2 часа ночью и 1 час в пятницу).
Расчёт: (43 200 − 180) / 43 200×100 = 99,58%
Результат: SLA выполнен (99,58% > 99,5%).
Теперь усложним задачу. Допустим, ночной инцидент длился не два часа, а четыре, при этом SLA считается только по рабочему времени (с 9:00 до 18:00). В этом случае ночные часы простоя в расчёт не войдут — это и есть логика технологических окон и рабочих периодов.
Именно поэтому в SLA важно чётко прописать: за какой период считается показатель, что включается в расчёт и что исключается из него.
Плановая доступность по SLA: 99,5%. Допустимое время простоя: 43 200 x (1 − 0,995) = 216 минут (~3,6 часа). Фактический простой за месяц: 180 минут (два инцидента — 2 часа ночью и 1 час в пятницу).
Расчёт: (43 200 − 180) / 43 200×100 = 99,58%
Результат: SLA выполнен (99,58% > 99,5%).
Теперь усложним задачу. Допустим, ночной инцидент длился не два часа, а четыре, при этом SLA считается только по рабочему времени (с 9:00 до 18:00). В этом случае ночные часы простоя в расчёт не войдут — это и есть логика технологических окон и рабочих периодов.
Именно поэтому в SLA важно чётко прописать: за какой период считается показатель, что включается в расчёт и что исключается из него.
Что такое нарушение SLA и как его предотвратить
Под нарушением понимают ситуацию, когда фактические показатели качества сервиса вышли за пределы согласованных значений. Например, время реакции на критическую заявку составило два часа вместо положенных 15 минут. Или доступность за месяц упала до 98,5% при плановых 99,9%.
Последствия могут быть разными:
Для предотвращения нарушений существует мониторинг SLA — система раннего предупреждения, которая сигнализирует об угрозе до того, как порог будет превышен.
Типичные причины нарушений:
1. Нет системы мониторинга — о проблеме узнают от пользователей, а не от инструментов.
2. SLA установлен, но не контролируется в реальном времени — данные собираются постфактум.
3. Нет автоматических оповещений — дежурный инженер не знает о приближении дедлайна по заявке.
4. Показатели SLA не привязаны к реальной инфраструктуре — мониторится что-то абстрактное, и непонятно, влияет ли это на сервис.
Последствия могут быть разными:
- операционные — эскалация, привлечение руководства, пересмотр регламентов;
- финансовые — штраф, возврат средств, скидки на следующий период;
- репутационные — заказчик теряет доверие и уходит.
Для предотвращения нарушений существует мониторинг SLA — система раннего предупреждения, которая сигнализирует об угрозе до того, как порог будет превышен.
Типичные причины нарушений:
1. Нет системы мониторинга — о проблеме узнают от пользователей, а не от инструментов.
2. SLA установлен, но не контролируется в реальном времени — данные собираются постфактум.
3. Нет автоматических оповещений — дежурный инженер не знает о приближении дедлайна по заявке.
4. Показатели SLA не привязаны к реальной инфраструктуре — мониторится что-то абстрактное, и непонятно, влияет ли это на сервис.
Как контролировать выполнение SLA: инструменты и процессы
Контроль SLA — это непрерывный процесс: совокупность инструментов, регламентов и персонала, который следит за тем, чтобы показатели соблюдались. SLA-контроль — это фундамент стабильной работы сервиса.
Мониторинг SLA: три уровня и инструменты контроля
Мониторинг SLA строится на трёх уровнях:
1) Метрики. Это сырые данные: загрузка CPU, время ответа базы данных, доступность сетевого оборудования. Они собираются системами мониторинга инфраструктуры.
2) События (инциденты). Если в данных обнаружена аномалия, система создаёт событие: «сервер недоступен более 5 минут», «диск заполнен на 95%». Это уже сигнал к действию.
3) ИТ-услуга (бизнес-сервис). Это верхний уровень, где события привязываются к конкретному бизнес-сервису и влияют на его SLA. Именно здесь происходит переход от технических метрик к бизнес-показателям.
«Если вы просто измеряете доступность сайта и видите 95% — вы не знаете, что с этим делать. Непонятно, почему он недоступен, что именно сломалось. SLA без контекста инфраструктуры — как таблетка от головной боли без понимания диагноза», — Дмитрий Унтила, руководитель «Пульта» и «Графини», «Лаборатория Числитель».
Чтобы эффективно контролировать SLA, нужна система, которая: собирает метрики в реальном времени; генерирует события при отклонениях; привязывает события к бизнес-сервисам через ресурсно-сервисную модель; автоматически рассчитывает текущий SLA; отправляет оповещения при угрозе нарушения; формирует отчётность для руководства и заказчиков.
1) Метрики. Это сырые данные: загрузка CPU, время ответа базы данных, доступность сетевого оборудования. Они собираются системами мониторинга инфраструктуры.
2) События (инциденты). Если в данных обнаружена аномалия, система создаёт событие: «сервер недоступен более 5 минут», «диск заполнен на 95%». Это уже сигнал к действию.
3) ИТ-услуга (бизнес-сервис). Это верхний уровень, где события привязываются к конкретному бизнес-сервису и влияют на его SLA. Именно здесь происходит переход от технических метрик к бизнес-показателям.
«Если вы просто измеряете доступность сайта и видите 95% — вы не знаете, что с этим делать. Непонятно, почему он недоступен, что именно сломалось. SLA без контекста инфраструктуры — как таблетка от головной боли без понимания диагноза», — Дмитрий Унтила, руководитель «Пульта» и «Графини», «Лаборатория Числитель».
Чтобы эффективно контролировать SLA, нужна система, которая: собирает метрики в реальном времени; генерирует события при отклонениях; привязывает события к бизнес-сервисам через ресурсно-сервисную модель; автоматически рассчитывает текущий SLA; отправляет оповещения при угрозе нарушения; формирует отчётность для руководства и заказчиков.
Контроль исполнения SLA в команде: от тикета до дашборда
Командный контроль исполнения SLA предполагает прозрачность: каждый должен понимать, за что он отвечает и в какие сроки должен реагировать. Для этого используются системы мониторинга и настроенные в ней правила контроля SLA и эскалации в случаях их нарушения и скором наступлении такой ситуации. Она фиксирует время наступления нарушения и время закрытия проблемы.
Не менее важна наблюдаемость. Дашборд с текущими показателями SLA должен быть виден всем заинтересованным сторонам: дежурной смене — в реальном времени, руководству — в виде регулярных отчётов, заказчикам — по запросу или автоматически.
В опытных командах работает автоматизация: если заявка приближается к дедлайну, система автоматически отправляет оповещение ответственному инженеру и при необходимости запускает эскалацию. Это снимает человеческий фактор и снижает вероятность нарушения. Контроль выполнения SLA в такой системе становится непрерывным.
Не менее важна наблюдаемость. Дашборд с текущими показателями SLA должен быть виден всем заинтересованным сторонам: дежурной смене — в реальном времени, руководству — в виде регулярных отчётов, заказчикам — по запросу или автоматически.
В опытных командах работает автоматизация: если заявка приближается к дедлайну, система автоматически отправляет оповещение ответственному инженеру и при необходимости запускает эскалацию. Это снимает человеческий фактор и снижает вероятность нарушения. Контроль выполнения SLA в такой системе становится непрерывным.
Как «Пульт» и «Графиня» помогают контролировать SLA
«Пульт» — российская система мониторинга ИТ-инфраструктуры от «Лаборатории Числитель», реализованная на основе Zabbix и включённая в реестр российского ПО. Среди сценариев использования — мониторинг ИТ-услуг: анализ состояния и доступности бизнес-сервисов, мониторинг SLA и KPI.
В «Пульте» реализована концепция трёхуровневого мониторинга. Система позволяет:
«Графиня» — платформа визуализации данных мониторинга, которая работает с «Пультом» и позволяет отображать всю собранную информацию по сервисам, событиям и метрикам в едином окне.
В «Пульте» реализована концепция трёхуровневого мониторинга. Система позволяет:
- контролировать инфраструктурные компоненты (серверы, сети, базы данных, российское оборудование) по 350+ готовым шаблонам;
- создавать ИТ-услуги — абстрактные логические сущности, которые описывают бизнес-сервис и его зависимости;
- строить ресурсно-сервисную модель (РСМ) — дерево зависимостей, где видно, какие компоненты на какой сервис влияют;
- отслеживать SLA каждого сервиса в реальном времени;
- настраивать технологические окна — периоды плановых работ, которые не учитываются при расчёте SLA;
- получать автоматические оповещения при деградации сервиса или угрозе нарушения SLA.
«Графиня» — платформа визуализации данных мониторинга, которая работает с «Пультом» и позволяет отображать всю собранную информацию по сервисам, событиям и метрикам в едином окне.
Частые ошибки при внедрении мониторинга SLA и как их избежать
Даже крупные компании с огромным опытом на рынке допускают ошибки, когда берутся за контроль SLA. Как контролировать SLA правильно? Для начала — избежать типичных промахов.
Ошибка 1: мониторинг есть, но нет каталога сервисов. Нельзя контролировать SLA того, что не описано. Прежде чем настраивать инструменты, нужно ответить на вопросы: какие сервисы у нас есть, кто за каждый из них отвечает, из каких компонентов он состоит и насколько критичен для бизнеса.
Ошибка 2: разрыв между техническими метриками и бизнес-контекстом. Самая распространённая ситуация: у вас есть технический мониторинг, но SLA не привязан к реальным сервисам. Вы видите, что «что-то 95%», но не понимаете, влияет ли это на работу бухгалтерии или на онлайн-продажи.
Ошибка 3: SLA рассчитывается постфактум. Если о нарушении вы узнаёте из ежемесячного отчёта, вы опоздали. Контроль SLA должен работать в реальном времени с проактивными оповещениями.
Ошибка 4: отсутствие технологических окон. Если плановые работы не выделены в отдельный период, они «съедают» SLA даже при идеальной работе в остальное время.
Ошибка 5: SLA установлен, но никто не несёт ответственности. Регламент есть, метрики считаются, но нет владельцев сервисов и понятного процесса эскалации. В итоге SLA превращается в формальность.
«Хуже всего — когда нет сквозного видения: есть технические метрики, но нет бизнес-контекста, или есть бизнес-контекст, но нет технического мониторинга. Этот разрыв — главная ошибка», — Дмитрий Унтила, руководитель «Пульта» и «Графини», «Лаборатория Числитель».
Ошибка 1: мониторинг есть, но нет каталога сервисов. Нельзя контролировать SLA того, что не описано. Прежде чем настраивать инструменты, нужно ответить на вопросы: какие сервисы у нас есть, кто за каждый из них отвечает, из каких компонентов он состоит и насколько критичен для бизнеса.
Ошибка 2: разрыв между техническими метриками и бизнес-контекстом. Самая распространённая ситуация: у вас есть технический мониторинг, но SLA не привязан к реальным сервисам. Вы видите, что «что-то 95%», но не понимаете, влияет ли это на работу бухгалтерии или на онлайн-продажи.
Ошибка 3: SLA рассчитывается постфактум. Если о нарушении вы узнаёте из ежемесячного отчёта, вы опоздали. Контроль SLA должен работать в реальном времени с проактивными оповещениями.
Ошибка 4: отсутствие технологических окон. Если плановые работы не выделены в отдельный период, они «съедают» SLA даже при идеальной работе в остальное время.
Ошибка 5: SLA установлен, но никто не несёт ответственности. Регламент есть, метрики считаются, но нет владельцев сервисов и понятного процесса эскалации. В итоге SLA превращается в формальность.
«Хуже всего — когда нет сквозного видения: есть технические метрики, но нет бизнес-контекста, или есть бизнес-контекст, но нет технического мониторинга. Этот разрыв — главная ошибка», — Дмитрий Унтила, руководитель «Пульта» и «Графини», «Лаборатория Числитель».
Главное об SLA
SLA (Service Level Agreement), или соглашение об уровне сервиса SLA — это измеримые обязательства по качеству услуги: доступности, времени реакции и решения. Они защищают и заказчика, и исполнителя, а также переводят технические показатели в бизнес-язык, сокращая разрыв между инженерами и менеджментом.
Основные метрики SLA: доступность, MTTR, MTBF, зависящие от согласованного периода обслуживания.
Формула расчёта SLA по доступности: (время работы / общее время) x 100. Сложность — в правильной настройке: что считать простоем, что исключать и за какой период.
Нарушение SLA — это выход за пределы согласованных показателей. Предотвратить его можно только через реальный мониторинг в реальном времени, а не через постфактумные отчёты.
Контроль SLA имеет три уровня: метрики инфраструктуры → события → бизнес-сервисы с ресурсно-сервисной моделью. Только при наличии всех трёх уровней мониторинг SLA работает эффективно.
Типичные ошибки при внедрении мониторинга SLA — отсутствие реестра сервисов, разрыв между техническими метриками и бизнес-контекстом, расчёт SLA постфактум и отсутствие ответственных.
«Пульт» от «Лаборатории Числитель» позволяет выстроить полноценный мониторинг SLA: от сбора метрик с инфраструктуры до отображения состояния бизнес-сервисов на дашбордах «Графини» в реальном времени.
Основные метрики SLA: доступность, MTTR, MTBF, зависящие от согласованного периода обслуживания.
Формула расчёта SLA по доступности: (время работы / общее время) x 100. Сложность — в правильной настройке: что считать простоем, что исключать и за какой период.
Нарушение SLA — это выход за пределы согласованных показателей. Предотвратить его можно только через реальный мониторинг в реальном времени, а не через постфактумные отчёты.
Контроль SLA имеет три уровня: метрики инфраструктуры → события → бизнес-сервисы с ресурсно-сервисной моделью. Только при наличии всех трёх уровней мониторинг SLA работает эффективно.
Типичные ошибки при внедрении мониторинга SLA — отсутствие реестра сервисов, разрыв между техническими метриками и бизнес-контекстом, расчёт SLA постфактум и отсутствие ответственных.
«Пульт» от «Лаборатории Числитель» позволяет выстроить полноценный мониторинг SLA: от сбора метрик с инфраструктуры до отображения состояния бизнес-сервисов на дашбордах «Графини» в реальном времени.
FAQ
Что такое SLA простыми словами?
SLA (Service Level Agreement) — это соглашение об уровне сервиса между заказчиком и исполнителем. В нём записано, как должен работать сервис и что будет, если договорённости нарушены. Например: сайт доступен 99,9% времени в месяц, а на критическую заявку отвечают в течение 15 минут. SLA переводит технические показатели на понятный бизнесу язык.
Как рассчитать SLA?
Для доступности используют формулу: SLA (%) = (общее время − время простоя) / общее время x 100. Например, в месяце 43 200 минут, а сервис простаивал 180 минут: (43 200 − 180) / 43 200×100 = 99,58%. Если SLA считается только по рабочим часам, нерабочее время и согласованные технологические окна из расчёта исключают.
Сколько простоя допускает SLA 99,9%?
SLA 99,9% допускает около 9 часов простоя в год, или примерно 43 минуты в месяц. Для сравнения: при 99% это уже около 88 часов в год, а при 99,99% — меньше часа. Поэтому разница в десятых долях процента для бизнеса принципиальна.
Учитываются ли плановые работы при расчёте SLA?
Обычно нет. Для плановых работ согласуют технологическое окно — период, который не входит в расчёт показателей. Если сервис недоступен во время регламентного обслуживания в таком окне, это не считается нарушением SLA.
Что такое нарушение SLA и чем оно грозит?
Нарушение SLA — это выход фактических показателей за согласованные значения: например, на критическую заявку ответили через два часа вместо 15 минут или доступность за месяц упала до 98,5% при плановых 99,9%. Последствия бывают операционные (эскалация, пересмотр регламентов), финансовые (штраф, возврат средств, скидки) и репутационные, когда заказчик теряет доверие и уходит.
Чем SLA отличается от SLO?
SLA — внешнее соглашение с заказчиком, за нарушение которого наступают последствия, например штраф. SLO (Service Level Objective) — внутренняя цель команды по тому же показателю. Обычно её ставят строже SLA, чтобы заметить проблему и успеть исправить её до того, как нарушится соглашение с клиентом.
SLA (Service Level Agreement) — это соглашение об уровне сервиса между заказчиком и исполнителем. В нём записано, как должен работать сервис и что будет, если договорённости нарушены. Например: сайт доступен 99,9% времени в месяц, а на критическую заявку отвечают в течение 15 минут. SLA переводит технические показатели на понятный бизнесу язык.
Как рассчитать SLA?
Для доступности используют формулу: SLA (%) = (общее время − время простоя) / общее время x 100. Например, в месяце 43 200 минут, а сервис простаивал 180 минут: (43 200 − 180) / 43 200×100 = 99,58%. Если SLA считается только по рабочим часам, нерабочее время и согласованные технологические окна из расчёта исключают.
Сколько простоя допускает SLA 99,9%?
SLA 99,9% допускает около 9 часов простоя в год, или примерно 43 минуты в месяц. Для сравнения: при 99% это уже около 88 часов в год, а при 99,99% — меньше часа. Поэтому разница в десятых долях процента для бизнеса принципиальна.
Учитываются ли плановые работы при расчёте SLA?
Обычно нет. Для плановых работ согласуют технологическое окно — период, который не входит в расчёт показателей. Если сервис недоступен во время регламентного обслуживания в таком окне, это не считается нарушением SLA.
Что такое нарушение SLA и чем оно грозит?
Нарушение SLA — это выход фактических показателей за согласованные значения: например, на критическую заявку ответили через два часа вместо 15 минут или доступность за месяц упала до 98,5% при плановых 99,9%. Последствия бывают операционные (эскалация, пересмотр регламентов), финансовые (штраф, возврат средств, скидки) и репутационные, когда заказчик теряет доверие и уходит.
Чем SLA отличается от SLO?
SLA — внешнее соглашение с заказчиком, за нарушение которого наступают последствия, например штраф. SLO (Service Level Objective) — внутренняя цель команды по тому же показателю. Обычно её ставят строже SLA, чтобы заметить проблему и успеть исправить её до того, как нарушится соглашение с клиентом.